AI, Full-stack
KODEKS: pravni asistent za bosanskohercegovačko zakonodavstvo zasnovan na RAG-u
Pravni asistent za policijske službenike u Bosni i Hercegovini, izgrađen uz Next.js, Supabase pgvector, OpenAI embeddinge i Claude, koji odgovara isključivo na osnovu zakona i pokazuje odakle dolazi svaki odgovor.
- Klijent
- Vlastiti proizvod (ANODA)
- Godina
- 2026
- Uloga
- Proizvod, arhitektura i kompletna implementacija
- Status
- U razvoju, namijenjen policijskim službenicima u Bosni i Hercegovini. Bez javne demonstracije.
- Vrsta
- RAG sistem (generisanje potpomognuto pretragom)
 Ilustracija
Ukratko
| Oblast | Pravo, provođenje zakona |
|---|---|
| Korisnici | Policijski službenici u Bosni i Hercegovini |
| Korpus | Domaće zakonodavstvo na bosanskom jeziku |
| Pristup | Generisanje potpomognuto pretragom, uz navođenje izvora |
| Embeddingi | OpenAI text-embedding-3-small, višejezični |
| Vektorska baza | Supabase PostgreSQL + pgvector |
| LLM | Anthropic Claude API |
| Aplikacija | Next.js |
| Status | U razvoju, bez javnog demoa |
Problem
Policijskim službenicima u Bosni i Hercegovini trebaju brzi i pouzdani odgovori iz zakona i propisa koji su dugi, rascjepkani i napisani na bosanskom jeziku. Na terenu nema vremena za pretragu nekoliko zakona da bi se pronašao onaj jedan član koji se primjenjuje.
Opći chatbotovi nisu rješenje: ili ne poznaju domaće zakone ili ih izmišljaju, a samouvjeren pogrešan odgovor o zakonu gori je od nikakvog odgovora. Pretraga PDF fajlova je tačna, ali spora, i funkcioniše samo ako već znate tačne riječi koje zakon koristi.
Zašto ne opći chatbot?
| Opći chatbot | Pretraga PDF fajlova | KODEKS | |
|---|---|---|---|
| Poznaje bosanskohercegovačke zakone | Djelimično | Da | Da |
| Odgovara jednostavnim jezikom | Da | Ne | Da |
| Pokazuje izvor | Ne | Da | Da |
| Priznaje kada ne zna | Ne | Djelimično | Da |
| Radi s varijantama BHS jezika | Djelimično | Ne | Da |
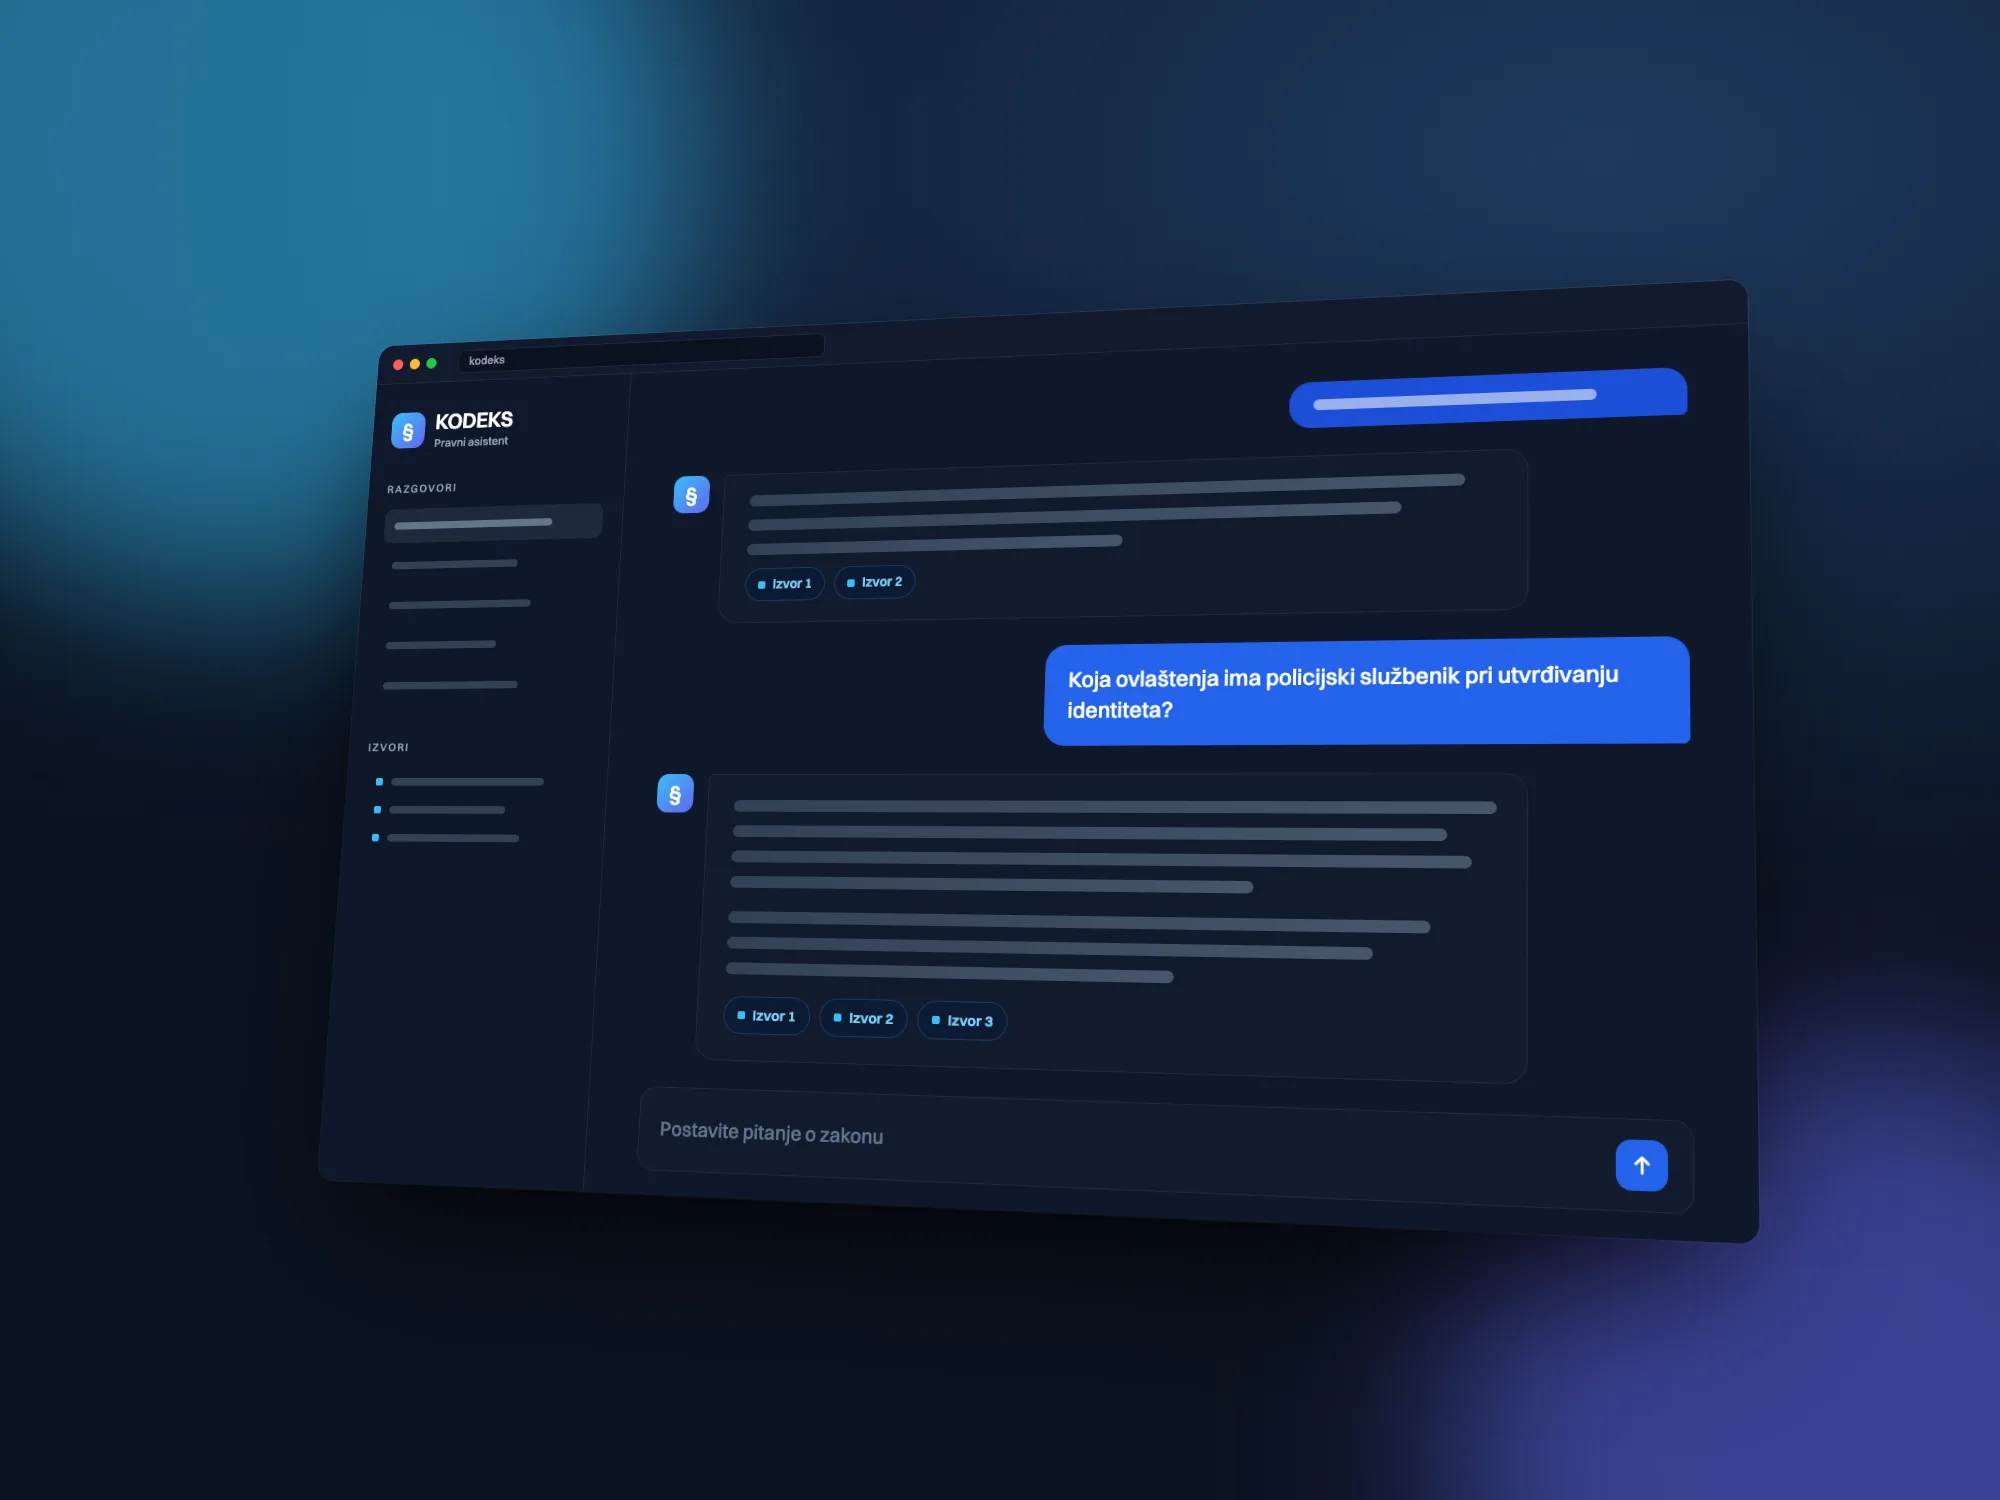
KODEKS
Kada policijski službenik može tražiti identifikaciju osobe?
Prema pronađenim odredbama, službenik može tražiti identifikaciju u slučajevima koje zakon izričito navodi. Za svaki slučaj navodim izvor, pa odgovor možete provjeriti u originalnom tekstu.
Ograničenja i odluke u dizajnu
| Ograničenje | Odluka |
|---|---|
| Pogrešan pravni odgovor gori je od nikakvog odgovora | Odgovori se generišu isključivo iz pronađenih odlomaka, a svaka tvrdnja navodi svoj izvor |
| Pravni tekst je dug i strukturiran (zakoni, članovi, stavovi) | Dokumenti se prije indeksiranja dijele na odlomke, a svaki odlomak čuva metapodatke o tome odakle potiče |
| Korisnici pišu na bosanskom, hrvatskom ili srpskom | Višejezični embedding model, tako da se značenje poklapa bez obzira na jezičku varijantu |
| Službenici moraju brzo provjeriti odgovor | Izvori se prikazuju kao linkovi na koje se može kliknuti, odmah uz odgovor |
| Trošak mora ostati nizak za alat javnog sektora | Mali, efikasan embedding model; LLM dobija samo relevantne odlomke |
Arhitektura
KODEKS ima dva pipelinea. Unos i obrada dokumenata (ingestion) radi offline i pretvara zakonodavstvo u odlomke (chunkove) koji se mogu pretraživati. Pipeline upita pokreće se za svako pitanje i gradi odgovor isključivo iz tih odlomaka.
Pravni dokumenti
Domaće zakonodavstvo
Parsiranje i normalizacija
Očišćen, ujednačen tekst
Podjela na odlomke
Uz metapodatke: zakon, član
Embedding
text-embedding-3-small
Pohrana vektora
Supabase pgvector
Pitanje korisnika
Na bosanskom, hrvatskom ili srpskom
Embedding pitanja
Isti embedding model
Pretraga po sličnosti
Vektorska pretraga u pgvectoru
Filter praga sličnosti
Zadržavaju se samo relevantni odlomci
Slaganje konteksta
Odlomci s oznakama izvora
Claude
System prompt koji vezuje odgovor za izvore
Odgovor uz navođenje izvora
Svaka tvrdnja ima izvor
Filter praga sličnosti →Nijedan odlomak ne prolazi: zamjenski odgovor. Navodi se šta nedostaje i predlaže kako preformulisati pitanje.
- 1Korisnik → Next.js aplikacijaPostavlja pitanje
- 2Next.js aplikacija → Embedding APIEmbedding pitanja
- 3Embedding API → Next.js aplikacijaVektor pitanja
- 4Next.js aplikacija → Supabase (pgvector)Pretraga po sličnosti
- 5Supabase (pgvector) → Next.js aplikacijaOdgovarajući odlomci s izvorima
- 6Next.js aplikacija → Claude APIPrompt vezan za izvore + odlomci
- 7Claude API → Next.js aplikacijaOdgovor uz navođenje izvora
- 8Next.js aplikacija → KorisnikOdgovor i izvori na koje se može kliknuti
Kako radi pretraga
Embedding model pretvara dio teksta u dugu listu brojeva, vektor, tako da tekstovi sličnog značenja završe blizu jedan drugog. Pitanje o "identifikaciji osobe" i član zakona o "utvrđivanju identiteta" nađu se jedno blizu drugog iako dijele malo zajedničkih riječi. Zbog toga isto pitanje radi bez obzira na to da li je napisano na bosanskom, hrvatskom ili srpskom.
Kada službenik postavi pitanje, KODEKS ga pretvara u vektor i od baze traži odlomke koji su mu najbliži. Samo odlomci koji su dovoljno blizu, unutar praga sličnosti, prosljeđuju se jezičkom modelu. Sve ostalo se zanemaruje, što odgovor drži fokusiranim, a trošak niskim.
Incident: asistent koji nije vraćao ništa
Tokom testiranja, neka sasvim razumna pitanja vraćala su prazan odgovor. Bez greške, bez pada sistema, jednostavno ništa korisno. Ovako sam otkrio zašto.
| Simptom | Neka legitimna pitanja vraćala su prazan odgovor, dok su druga o istom zakonu radila normalno. |
|---|---|
| Hipoteza | Problem nije bio u modelu. Nešto prije njega uklanjalo je kontekst koji mu je trebao. |
| Šta sam provjerio | Koje odlomke pretraga po sličnosti vraća za problematična pitanja, prije i poslije filtera praga sličnosti, i šta model dobija kada nijedan odlomak ne prođe. |
| Uzrok 1 | Prag sličnosti odbacivao je sve kandidate za pitanja formulisana drugačije od pravnog teksta. |
| Uzrok 2 | System prompt nije imao uputu za slučaj "nema relevantnog konteksta", pa model nije imao šta reći. |
| Rješenje | Prag sam podesio na stvarnim pitanjima, osigurao da se najbolji odlomci i dalje uzimaju u obzir kada nijedan ne pređe prag, i dodao eksplicitnu uputu: reci šta nedostaje umjesto da nagađaš. |
Prije
Pitanje postavljeno svakodnevnim riječima
Prazan odgovor
Poslije
Isto pitanje
Odgovor s izvorima ili iskreno "nije pronađeno u indeksiranim zakonima"
"Pretraga i generisanje zakazuju na različite načine. Sada ih mjerim odvojeno."
Pravila vezivanja odgovora za izvore u system promptu
System prompt pretvara model iz općeg asistenta u pažljivog asistenta. Nameće sljedeća ponašanja:
- Odgovaraj isključivo na osnovu dostavljenih odlomaka.
- Navedi izvor za svaku tvrdnju.
- Odgovaraj na jeziku korisnika.
- Jasno reci kada odlomci ne pokrivaju pitanje.
- Nikada ne predstavljaj odgovor kao pravni savjet.
Evaluacija
KODEKS evaluiram skupom stvarnih pitanja, gdje je svako upareno s odlomcima koje bi pretraga trebala vratiti. Pretragu mjerim odvojeno od kvaliteta odgovora, pa kada nešto krene po zlu, znam koju polovinu sistema treba pogledati.
| Metrika | Šta mi govori |
|---|---|
| Recall@k | Da li se pravi odlomak našao među prvih k vraćenih odlomaka? |
| MRR (srednji recipročni rang) | Koliko je visoko, u prosjeku, rangiran prvi tačan odlomak. |
| Oslonjenost na izvore (groundedness) | Da li je svaka tvrdnja u odgovoru potkrijepljena navedenim odlomkom? |
| Ispravno odbijanje | Da li asistent kaže "nije pronađeno" kada zakon ne pokriva pitanje? |
Odgovorna upotreba AI-ja
- Svaki odgovor navodi izvore, tako da službenik može provjeriti originalni tekst.
- Nijedan odgovor se ne generiše bez pronađenog konteksta.
- Prije šire upotrebe planirano je jasno upozorenje u interfejsu da odgovor "nije pravni savjet".
Sljedeći koraci, još nisu urađeni
Plan razvoja
Hibridna pretraga
Kombinacija pretrage po ključnim riječima i vektorske pretrage, kako bi se tačni pravni izrazi i brojevi članova poklapali jednako dobro kao i značenje.
Reranking
Ponovno rangiranje pronađenih odlomaka posebnim modelom prije nego što stignu do LLM-a.
Automatska evaluacija u CI-ju
Pokretanje evaluacijskog skupa pri svakoj izmjeni, kako kvalitet pretrage ne bi mogao neprimjetno opasti.
Tracing i observability
Bilježenje svakog upita, pronađenih odlomaka i odgovora, radi otklanjanja grešaka i poboljšanja na osnovu stvarnih podataka.
Tehnologije
| Sloj | Tehnologija | Zašto |
|---|---|---|
| Frontend | Next.js | Jedan framework za interfejs i za pozive AI servisima sa servera |
| Embeddingi | OpenAI text-embedding-3-small | Dobro radi s bosanskim, hrvatskim i srpskim, uz nizak trošak |
| Vektorska baza | Supabase PostgreSQL + pgvector | Vektori stoje uz ostale podatke, u bazi kojoj već vjerujem |
| LLM | Anthropic Claude API | Precizno slijedi upute da odgovara samo iz izvora i piše jasne odgovore uz navođenje izvora |
| Jezik | TypeScript | Jedan tipizirani jezik kroz cijelu aplikaciju |
Pojmovnik
Deset pojmova, jednostavnim jezikom
- RAG
- Generisanje potpomognuto pretragom (retrieval-augmented generation): model prvo pronađe relevantan tekst, a zatim odgovara koristeći samo taj tekst.
- Embedding
- Lista brojeva koja predstavlja značenje nekog dijela teksta.
- Vektor
- Sama ta lista brojeva; tekstovi sličnog značenja imaju vektore koji su blizu jedan drugom.
- Kosinusna sličnost
- Način mjerenja koliko su dva vektora blizu, na osnovu ugla između njih.
- Odlomak (chunk)
- Dio većeg dokumenta, dovoljno mali da se može pretraživati i proslijediti modelu.
- Top-k
- k najsličnijih odlomaka koje vrati pretraga.
- Prag sličnosti
- Minimalna sličnost koju odlomak mora imati da bi bio iskorišten.
- Vezivanje za izvore (grounding)
- Navođenje modela da odgovara na osnovu datih izvora, a ne svog općeg znanja.
- Halucinacija
- Samouvjeren odgovor koji nije potkrijepljen izvorima niti stvarnošću.
- Recall@k
- Udio pitanja kod kojih se pravi odlomak nalazi među prvih k rezultata.